GitHubのトレンドに paperless-ngx/paperless-ngx が上がっていて、リリース一覧を見たら前日の2026-09-19に v3.2.0 が出たばかりでした。書類をスキャンして放り込むとOCRして全文検索できるようにしてくれる、いわゆる文書管理システムです。スター数は45,349。
私は以前、紙の請求書や領収書をフォルダ分けだけで管理して痛い目を見た経験があります。探すときに「あの会社の、たしか8月の」までは思い出せても、ファイル名がスキャナ任せの連番なので結局1枚ずつ開く羽目になる。そういう用途にこれがどこまで効くのか、特に 日本語の書類 でどう振る舞うのかを見ておきたかったんですよね。
インストール方法は3つ用意されていて、公式が勧めるのは docker compose です。ただ今回はあえて Bare Metal Install の手順を、素の python:3.12-bookworm コンテナ1台の中で手でなぞりました。理由は単純で、イメージが面倒を全部隠してくれると「何が動いていて、どこで何が決まっているか」が見えないからです。結果としてこの選択が、後半の検索まわりのハマりを引き当てることになります。
環境と、pipが落としてくる1.5GB
試した環境はこうです。
- Debian 12 (bookworm) のコンテナ、
--memory=4g --cpus=2 - Python 3.12.13 / Django 5.2.16 / Redis 7.0.15(同じコンテナ内で
redis-server --daemonize yes) - paperless-ngx v3.2.0 のリリースアーカイブ
paperless-ngx-v3.2.0.tar.xz(222,568,512バイト、展開後690MB) - OCR まわりは apt の tesseract 5.3.0 +
tesseract-ocr-jpn、ocrmypdf 17.11.0 - DBはSQLite
ドキュメントの Bare Metal 手順は「aptで依存を入れる → Redisを用意 → リリースを展開 → paperless.conf を書く → pip3 install -r requirements.txt → migrate」という流れで、私は pip の代わりに uv を使いました。最初のアプローチは素直に uv pip install --system -r requirements.txt です。これが落ちました。
# apt 依存 + redis-server + tesseract-ocr-jpn + fonts-noto-cjk など
apt_ms=18326

# リリースを展開(222,568,512 バイト → 690M /opt/paperless)
download_extract_ms=24012

# 最初のアプローチ: uv でそのまま
$ uv pip install --system -r requirements.txt
  cause: Because there is no version of certifi{...}==2026.1.4 and you require certifi==2026.1.4,
  we can conclude that your requirements are unsatisfiable.
hint: `certifi` was found on https://download.pytorch.org/whl/cpu, but not at the requested version
  (certifi==2026.1.4). ... If all indexes are equally trusted, use `--index-strategy unsafe-best-match`
uv_rc=1

# 改善後: index-strategy を緩める
$ uv pip install --system --index-strategy unsafe-best-match -r requirements.txt
Resolved 202 packages in 1.89s
Prepared 202 packages in 5.57s
Installed 202 packages in 358ms
uv_rc=0

$ du -sm /usr/local/lib/python3.12/site-packages
1552
$ du -sm site-packages/torch
711

# migrate(106 マイグレーション)と superuser 作成
migrate_ms=11514
Superuser created successfully.
requirements.txt の先頭を見ると uv export --no-dev --all-extras --emit-index-url で生成されていて、--extra-index-url https://download.pytorch.org/whl/cpu が書かれています。uv は「あるパッケージを最初に見つけたインデックスの版しか使わない」のが既定なので、pytorch のインデックスにも置いてある certifi がそちらの古い版で固定されてしまい、pypi 側の 2026.1.4 に届かない。pip なら気にせず通る話で、ドキュメントの手順通り pip3 を使っていれば踏まなかった穴です。今思えば「uv を使ってもよい」と書いてあるのは uv sync の話であって、requirements.txt を uv に食わせる組み合わせは想定外だったのかもしれません。
それより気になったのは容量のほうです。site-packages が 1,552MB あって、うち torch が 711MB。sentence-transformers、transformers、llama-index、openai、sympy あたりを足すと 868MB、全体の56%がAI機能まわり でした。pyproject.toml を読むと torch>=2.13,<2.15 や llama-index-core は optional な extra ではなく base dependencies に入っています。一方で設定の PAPERLESS_AI_ENABLED は既定 NO。つまり使わない機能のために、素のインストールでも torch が必ず降ってくる構造です。Docker イメージを使っている限り気づかない数字だと思います。
もうひとつ、ImageMagick のポリシーで PDF のサムネイル生成が拒否されて ghostscript にフォールバックする警告も出ました。これはドキュメントの手順12に「ほとんどのディストリビューションはPDF処理を無効にしている」と書いてある通りで、動作自体は継続します。
コンテナを起動してから granian が HTTP 302 を返すまでは、上のダウンロードや私が手順を打つ時間も含めて 2分49秒でした。
日本語の請求書を食わせる
consume ディレクトリを監視する document_consumer、実際の処理をする celery worker、Webの granian を立てて、合成した「スキャン画像だけのPDF」を投げ込みます。中身は架空の請求書(発行日・請求番号・金額・振込期限)で、文字はNoto Sans CJKで描画した画像なので、埋め込みテキストは1バイトもありません。
最初は PAPERLESS_OCR_LANGUAGE を書かずに投げました。既定は eng です。取り込みは約7秒で終わり、エラーは出ません。ただし本文はこうなりました。
# PAPERLESS_OCR_LANGUAGE 未設定(既定 eng)
MISA Y TLS

3£47 A: 2026449208

aa kes: INV-2026-0920

12: 759 KR —ER IAS
/\\et: 120,000F9
...
Gat Bes: 132,000

# PAPERLESS_OCR_LANGUAGE=jpn+eng にして worker を再起動、同じPDFを再投入
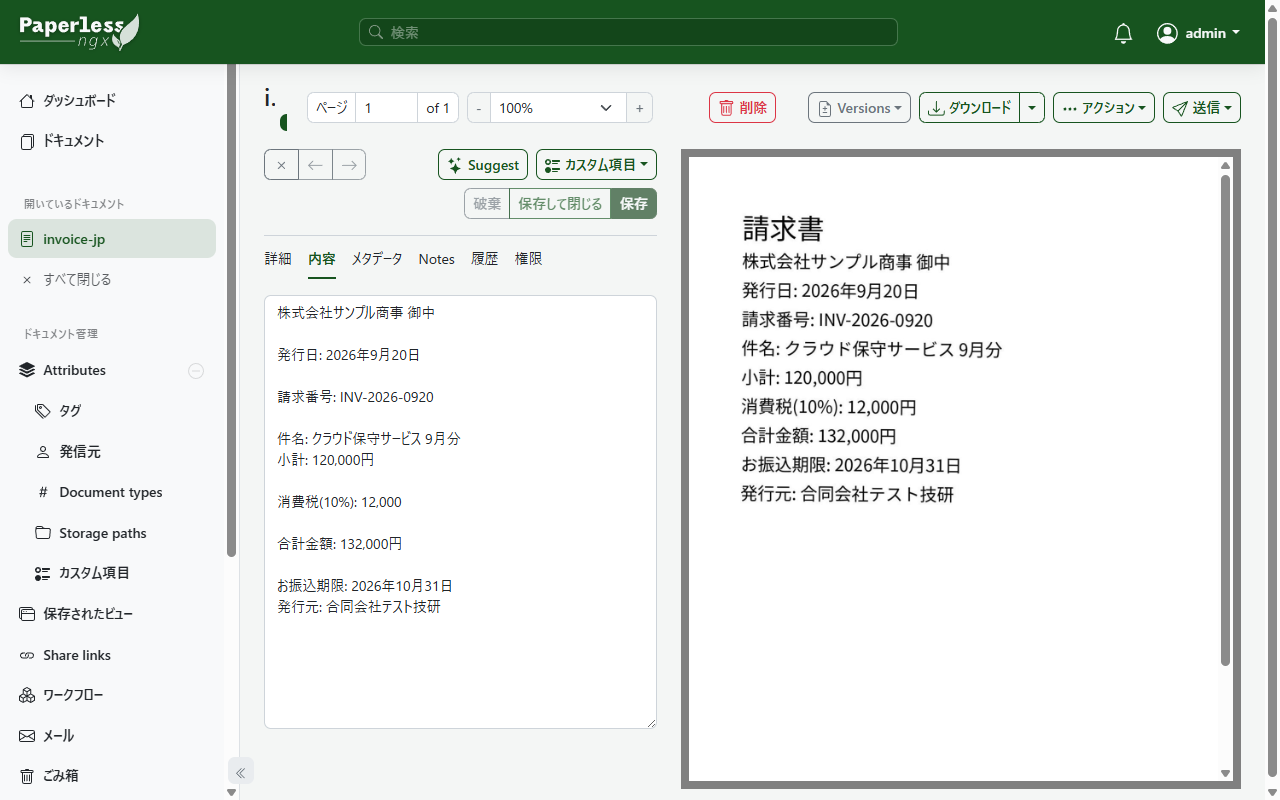
株式会社サンプル商事 御中

発行日: 2026年9月20日

請求番号: INV-2026-0920

件名: クラウド保守サービス 9月分
小計: 120,000円

消費税(10%): 12,000

合計金額: 132,000円

お振込期限: 2026年10月31日
発行元: 合同会社テスト技研
jpn+eng にすると本文はほぼ完璧です。ただ、PDFの一番上に一番大きく書いた「請求書」の3文字だけが どこにもない。領収書のPNGでも同じで、大見出しの「領収書」が NS になり、本文は読めています。
paperless の外で切り分けました。同じ本文に見出しサイズだけ変えたPNGを作って tesseract img - -l jpn+eng を1枚ずつ別プロセスで通すと、見出しが 40px / 56px / 64px のときは「請求書」が正しく出て、80px は「三主」、100px は「三詩」になります。領収書の見出しは70pxでした。ocrmypdf はここに --deskew や --clean(unpaper)を挟むので、64pxの請求書でも paperless 経由だと落ちたのだと思いますが、そこは深追いしていません。一次情報として言えるのは「本文サイズの日本語は拾い、タイトル級の大きさは落ちることがある」までです。
ついでに分かったことがひとつ。同じPDFをもう一度投げても弾かれず、2件目として取り込まれました。ログには Consuming duplicate invoice-jp.pdf: 1 existing document(s) share the same content. と WARNING が出るだけです。設定リファレンスを引くと PAPERLESS_CONSUMER_DELETE_DUPLICATES の説明に「As of version 3.0 Paperless-ngx allows duplicate documents to be consumed by default」とあって、v3で既定が反転していました。2系から上げる人は覚えておいたほうがいい挙動です。
2026-08-05 が5月8日になる
書類管理で一番効いてほしいのは「作成日」の自動検出です。日付の形式を変えた4枚のメモを投げて、created に何が入るかを見ました。
| 書類に書いた日付 | 既定(DATE_ORDER=DMY) | PAPERLESS_DATE_ORDER=YMD |
|---|---|---|
| 日付: 2026年8月5日 | 2026-09-20(取り込み日) | 2026-09-20(取り込み日) |
| 日付: 2026/08/05 | 2026-05-08 | 2026-08-05 |
| 日付: 2026-08-05 | 2026-05-08 | 2026-08-05 |
| Date: August 5, 2026 | 2026-08-05 | (未検証) |
2026/08/05 が 5月8日 になるのは、既定の PAPERLESS_DATE_ORDER が DMY で、年の後ろの2つを「日・月」の順に読むからです。エラーも警告も出ず、単に5月の書類として保存されます。YMD にすれば数字の形式は正しくなります。ここまでは設定の問題で、ドキュメントにも書いてあります。
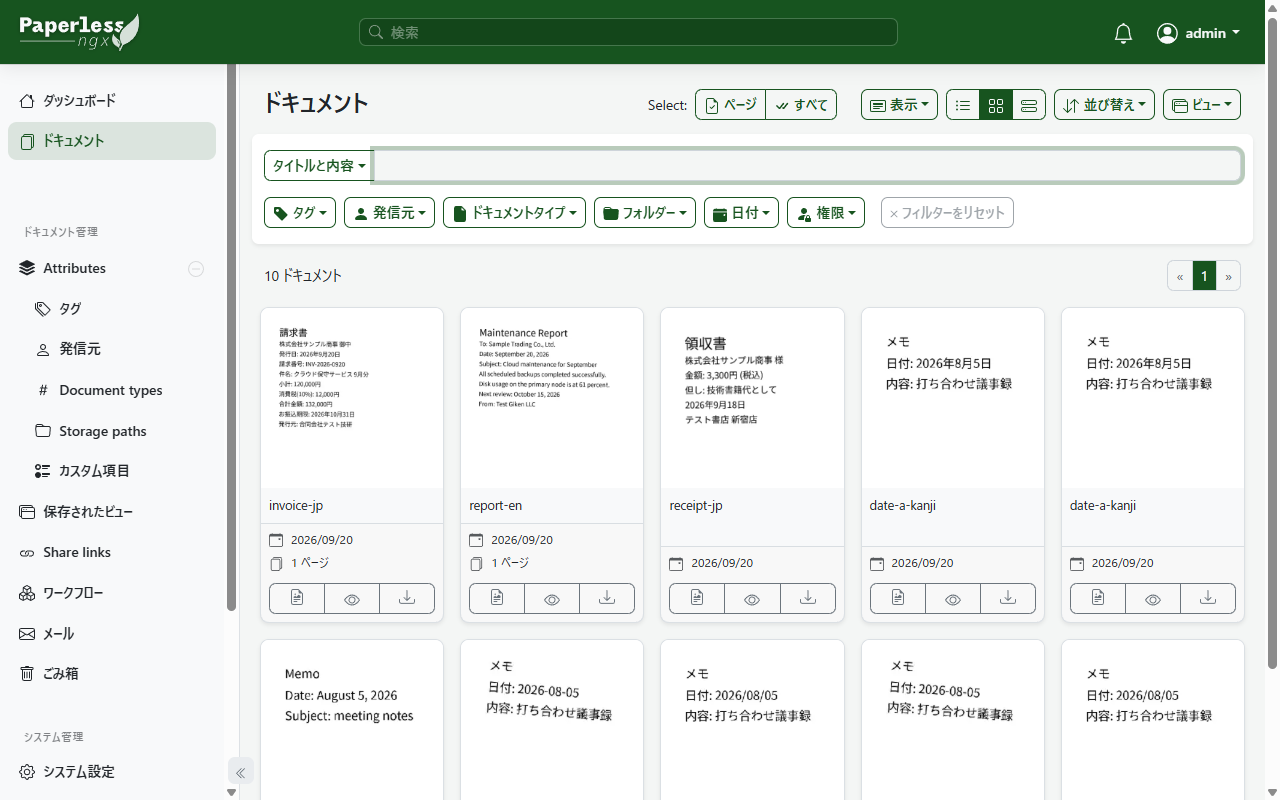
一覧で見ると、年月日で書いたメモは取り込み日の 2026/09/20 のまま並んでいます(ついでに言うと、傾き補正を通ったサムネイルが元画像より少し傾いて見えるのも気になりましたが、これは追いかけていません)。「2026年8月5日」だけは何をしても取り込み日のままでした。src/documents/plugins/date_parsing/regex_parser.py の DATE_REGEX を読むと、\d{1,2}[\.\/-]\d{1,2}[\.\/-]\d{4} のような数字区切りと、August 5, 2026 のようなラテン文字の月名だけで、年月日の形は候補にすら上がりません。候補抽出を通った文字列だけが dateparser(1.4.3)に渡る作りなので、dateparser 側が日本語を読めても出番がない。日本の書類は年月日表記が圧倒的なので、ここは実質「作成日の自動検出は期待しない」か、date_parsing/__init__.py にある entry_points 経由のプラグイン差し替えで自前パーサを入れるか、どちらかになります。
検索は「ンプル商」で当たる。そして英単語だけが消える
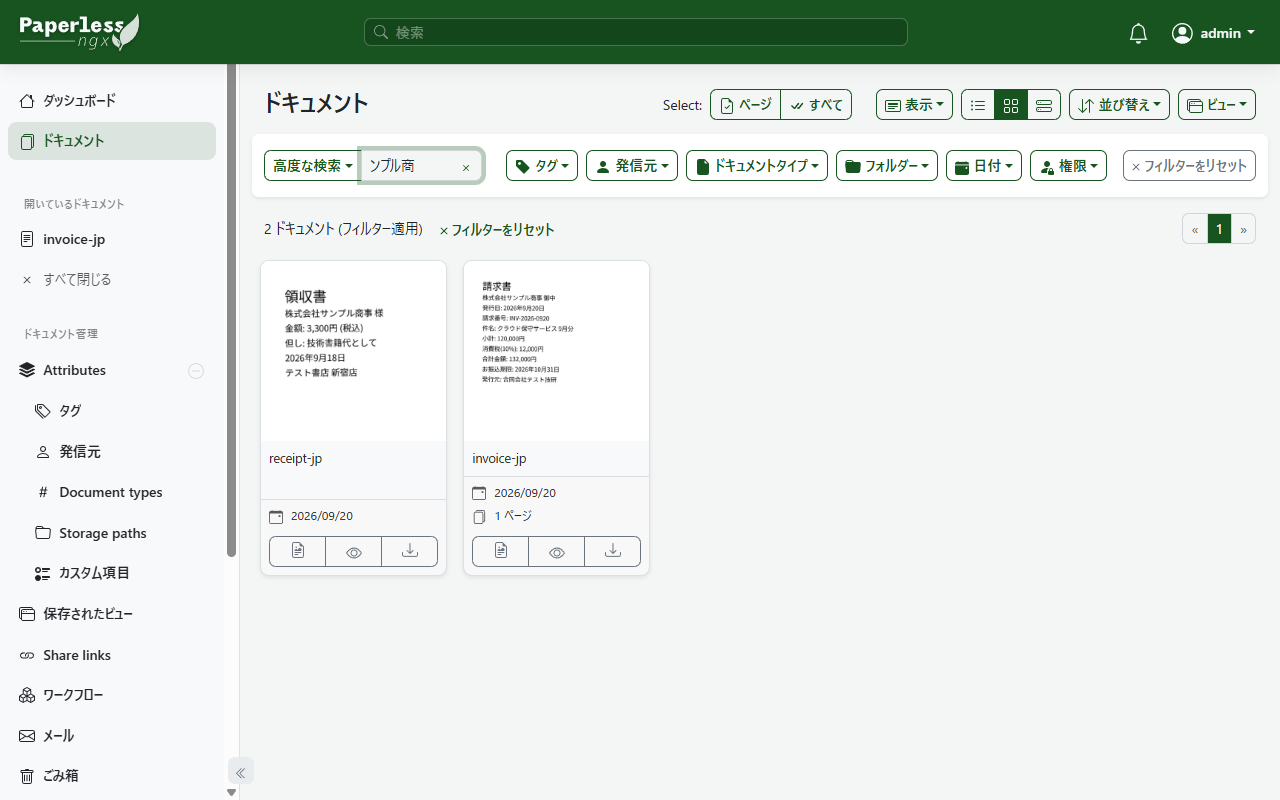
ここが今回一番面白かったところです。v3 の全文検索は Whoosh から Tantivy(Rust製、Python バインディング 0.26.0)に載せ替わっていて、src/documents/search/_backend.py には bigram_title / bigram_content という CJK 用の文字バイグラム フィールドが切ってあります。実際、「サンプル商事」でも、語の途中を切り出した「ンプル商」でも、請求書と領収書の2件がヒットしました。1文字の「商」は0件です。日本語のセルフホスト検索で分かち書きの問題に当たった経験が何度かあるので、これは正直なところ嬉しい。
ところが同じ画面で、英語のメンテナンス報告書(本文に Maintenance Report と backups を含む)を maintenance で引くと 0件 でした。report や cloud は当たる。backups も scheduled も completed も0件。
原因は、私が OCR 言語を eng から jpn+eng に変えたとき worker だけ再起動して web を再起動しなかった ことでした。ステマー(語幹処理)の言語は PAPERLESS_SEARCH_LANGUAGE が未設定だと OCR 言語の先頭から推測されて、eng なら English、jpn は Tantivy に対応ステマーが無いので「無し」になります。つまり web は English ステマー付きで maintenance → mainten に変形して検索し、worker は変形なしで maintenance のまま索引していた。report や cloud は語幹処理しても形が変わらないので当たる。両方再起動したらきれいに揃いました。
| 状態 | maintenance | backups | backup(単数) | ンプル商 |
|---|---|---|---|---|
| OCR=jpn+eng、worker のみ再起動 | 0件 | 0件 | 0件 | 2件 |
| 同上、web も再起動(ステマー無し) | 1件 | 1件 | 0件 | 2件 |
| SEARCH_LANGUAGE=en 追加、両方再起動 | 0件 | 0件 | 0件 | 0件 |
同上 + document_index reindex | 1件 | 1件 | 1件 | 2件 |
2行目を見ると、ステマー無しでは backup が backups に当たりません。日本語書類のために OCR を jpn 先頭にすると、英語書類の検索が「完全一致だけ」に静かに退化するわけです。対処は PAPERLESS_SEARCH_LANGUAGE=en を明示すること。設定リファレンスに「変更すると次回起動時に索引が自動で作り直される」とあるので、追記して web と worker を再起動しました。
その結果が3行目です。日本語まで含めて全部0件。
# web の起動ログ
[INFO] [paperless.search] Search index language changed - rebuilding.

# 索引ディレクトリ: セグメントが消え、設定センチネルだけ新しい
$ cat data/index/.index_settings.json
{"schema_version": 2, "language": "en", "schema_fingerprint": "71d5..."}
segments max_doc: []

# Docker イメージの起動スクリプトが叩いているのと同じコマンドを手で実行
$ python3 manage.py document_index reindex --if-needed
Search index is up to date.
segments max_doc: []                      # ← 0件のまま

# 条件を付けずに実行
$ python3 manage.py document_index reindex --no-progress-bar
reindex_ms=1304
segments max_doc: [9, 1]                  # 10 件が戻った
_schema.py の needs_rebuild() は「言語が変わった」と判定すると wipe_index() で索引を空にし、新しいスキーマで空の索引を作って .index_settings.json を書き直します。ここまでは web の起動時に走る。文書を索引に入れ直すのは別のコマンド document_index reindex の仕事で、Docker イメージでは s6-rc.d/init-search-index/run が webserver より前に reindex --if-needed を実行するので問題になりません。Bare Metal ではその順番を守る人が誰もいない。先に web が起動して「言語は en、スキーマも最新」というセンチネルを書いてしまうので、後から --if-needed を叩いても「up to date」と言われ、0件の索引がそのまま残ります。
これは不具合というより、compose を前提にした運用手順を手動で崩した私の側の問題です。ただ「設定を1行足したら検索が全滅し、公式のメンテナンスコマンドは正常と答える」という組み合わせは、運用中に踏むと切り分けに時間がかかるタイプのケースだと思います。Bare Metal の人は、PAPERLESS_SEARCH_LANGUAGE や OCR 言語を変えたら web を止めたまま document_index reindex --if-needed を流す、を習慣にするのが安全です。
試してみての所感
私が今回学んだことを、設定ファイルの行数で言うと4行です。
PAPERLESS_OCR_LANGUAGE=jpn+eng     # 無いと日本語は化ける(既定 eng)
PAPERLESS_DATE_ORDER=YMD           # 無いと 2026/08/05 が 5月8日(既定 DMY)
PAPERLESS_SEARCH_LANGUAGE=en       # 無いと jpn 先頭で英語ステマーが消える
# そして上を変えたら web を止めて document_index reindex --if-neededそのうえで、日本語の全文検索がバイグラムで最初から効くのは大きい。年月日の日付検出が無いのと、大見出しが落ちるのは、どちらも「本文が検索できれば実用上は困らない」範囲だと今は考えています。請求書なら「INV-2026-0920」や「サンプル商事」で引けますし、2026 だけでも7件当たるくらいには数字も拾えている。
一方で、素の Python 環境に 1.5GB、うち 868MB が既定オフのAI機能のためというのは、運用を考えると引っかかります。使うつもりが無いなら Docker イメージのサイズに埋もれて気づかないほうが幸せなのかもしれませんが、私は知ってしまったので、次にバージョンを上げるときは pyproject.toml の dependencies を先に見に行くと思います。
自分の書類管理に使うかどうかは、年月日の日付検出をプラグインで足せるか試してから決めるつもりです。v3 で内部の検索エンジンが丸ごと変わったばかりのタイミングでもあるので、ステマーまわりの挙動はしばらく様子見ですね。