GitHubのトレンドで dream-num/univer を見かけました。説明文が「The Office Harness for AI Agents」となっていて、そこで手が止まりました。
私はPM側の人間なので、コードそのものより「これを案件に入れるとしたら、何が自前で、何が有償なのか」を先に知りたくなります。ここ半年、エージェントに見積書やレポートを組ませたいという相談を何度か受けていて、そのたびに「Excelの読み書きはライブラリで、計算式の評価は誰がやるのか」という話で止まっていました。表計算の式まで含めて丸ごと持っている実行基盤があるなら、話の前提が変わります。
というわけで、使い捨てのコンテナで動かしてみました。結論を先に書くと、Nodeだけで式が回るところまでは想像以上にあっさり着きました。躓いたのはその先、保存したファイルを読み直したときです。
試した環境
ホストを汚さない方針なので、cloneから実行まで全部使い捨てコンテナの中で完結させています。以下の数値は全部その中の実測です。
- 対象:
dream-num/univer(Apache-2.0 / スター17,061 / 主要言語TypeScript)。npmは1.0.2、これは検証した当日の11:32Z(UTC)に公開されたばかりのもの。リポジトリのdevHEAD は1defaf4a - ベースイメージ:
node:22-bookworm(Debian GNU/Linux 12.14、Node v22.23.1、npm 10.9.8、x86_64) - 制限:
--memory=4g --cpus=2 --pids-limit=512 - ブラウザ側の確認だけホストのChromeから
127.0.0.1限定の公開ポート越しに実施
monorepoのcloneは6.77秒で151MB(7,248ファイル)ありましたが、実際に使ったのは公開されているnpmパッケージのほうです。
Nodeだけで表計算が回る
ヘッドレス用のプリセットが @univerjs/preset-sheets-node-core という名前で公開されています。ブラウザ用と同じ createUniver() に、UIプラグインを外したプリセットを渡すだけ、という構造です。
# --- 1. 入れる(node:22-bookworm のコンテナ内) ---
npm install @univerjs/presets@1.0.2 @univerjs/preset-sheets-node-core@1.0.2
# -> install_ms=4946 / 78 packages / node_modules 107,398,191 bytes(@univerjs/* は24パッケージ)

# --- 2. プロセス起動から計算結果を読むまで ---
node case-basic.mjs
# import_ms=323
# createUniver_ms=4
# createWorkbook_ms=30
# sheet_name=Sheet1
# A3_before_calc=null              ← 式を入れた直後はまだ null
# calculationEnd_state=3 after_ms=36
# A3_after_calc=3
# A3_cellData={"f":"=SUM(A1:A5)","v":3,"t":2}
# total_ms=402
jsdomも仮想DOMも要りませんでした。素のNodeで require して402ms後には計算済みの値が読めています。
ここで一点、式を入れた直後の getValue() は null を返すというのが最初の引っかかりでした。計算はイベント駆動で、univerAPI.getFormula().calculationEnd(cb) のコールバックを待つ必要があります。公式のJSDocにも同じ書き方(if (functionsExecutedState === 3))で例が載っているので、素直にそれに従えば動きます。理屈はそうなんですが、この「3」が後で効いてきます。
関数はどこまで通るのか
案件で使えるかどうかは、結局「うちの帳票で使っている関数が通るか」で決まります。現場では、ここを確かめずに採用を決めると、後半で必ず詰みます。
31本を1枚のシートに並べて一括で評価させました。全部で78msです。
SUM           | =SUM(B1:B5)                                | v=150
XLOOKUP       | =XLOOKUP("cherry",A1:A5,B1:B5)             | v=30
LET           | =LET(x,SUM(B1:B5),x*2)                     | v=300
LAMBDA_direct | =LAMBDA(x,x*3)(7)                          | v=21
REDUCE        | =REDUCE(0,B1:B5,LAMBDA(acc,v,acc+v))       | v=150
SEQUENCE_spill| =SEQUENCE(3,1)                             | v=1   (下のセルに 2 がスピル)
TEXTSPLIT     | =TEXTSPLIT("a-b-c","-")                    | v="a" (右のセルに "b" がスピル)
GROUPBY       | =GROUPBY(A1:A5,B1:B5,SUM)                  | v="apple"(右に30、下に"banana")
PIVOTBY       | =PIVOTBY(A1:A5,A1:A5,B1:B5,SUM)            | v="#NAME?"
DATEDIF       | =DATEDIF(DATE(2026,1,1),DATE(2026,9,24),"d") | v=266
REGEXEXTRACT  | =REGEXEXTRACT("abc123","[0-9]+")           | v="123"
IMAGE         | =IMAGE("https://example.com/x.png")        | v=""
DIV0_err | =1/0 | v="#DIV/0!"| 種別 | 試した関数 | 結果 |
|---|---|---|
| 集計・検索の定番 | SUM / AVERAGE / COUNTIF / SUMIFS / VLOOKUP / INDEX+MATCH | 全部期待どおり |
| 新しめの関数 | XLOOKUP / XMATCH / IFS / SWITCH / LET / LAMBDA / MAP / REDUCE / FILTER / UNIQUE / SORT / VSTACK / TOCOL / TEXTSPLIT / TEXTBEFORE | 全部通った。スピルも縦横とも効く |
| 通らなかったもの | PIVOTBY | #NAME?(GROUPBYは動く) |
| エラー系 | =1/0 / 空セル参照 | #DIV/0! / 0(Excel互換の挙動) |
正直なところ、ここは想定よりずっと良かったところです。LAMBDAとREDUCEが通る表計算エンジンをApache-2.0で持っていけるなら、それだけで検討する理由になります。
同じAPIがブラウザでも動く
ヘッドレスで作ったものと同じ createUniver() を、今度はUI付きのプリセット(@univerjs/preset-sheets-core)でVite 8.3.0のdevサーバーに載せました。商品・数量・単価・金額の小さな表に、合計・XLOOKUPでの最高額商品・LETでの構成比を入れています。
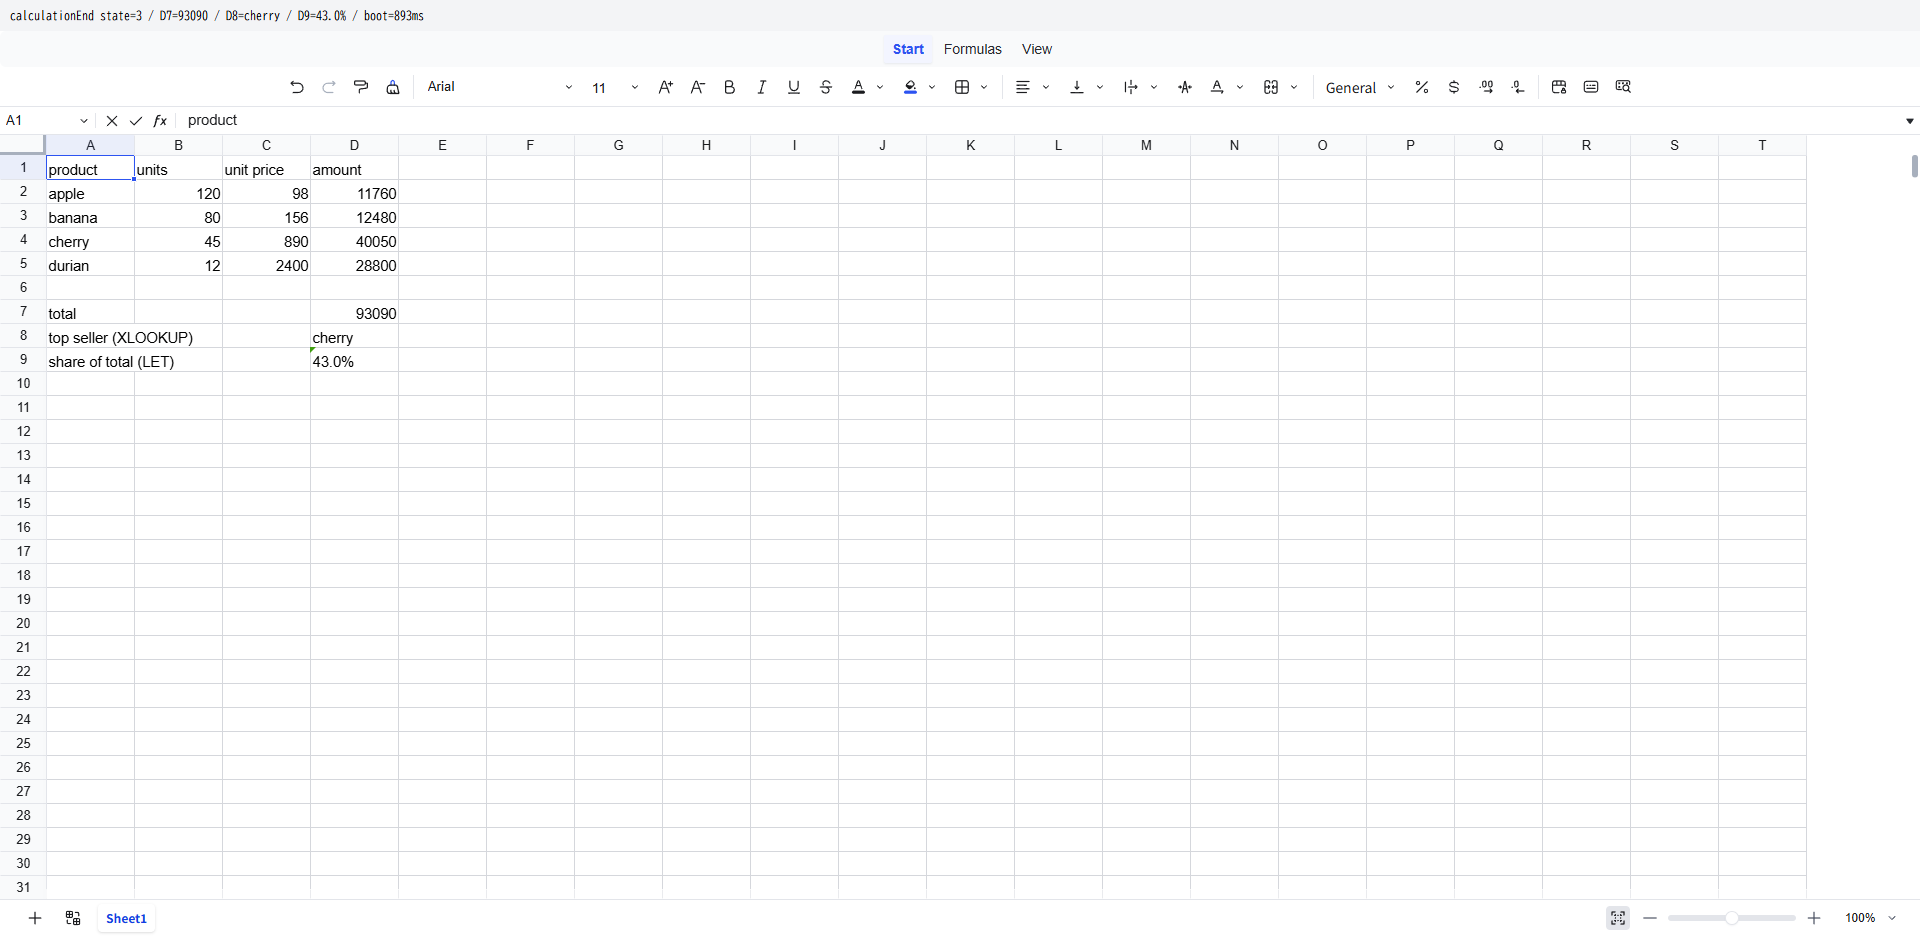
ページを開いてから計算完了までが893ms。ツールバー、数式バー、行列ヘッダ、シートタブまでひと通り揃っていて、コンソールにエラーは出ていません。
次に、エージェント役として画面を触らずにFacade APIから値を書き換えてみました。B2 の数量を120から900に変えるだけです。
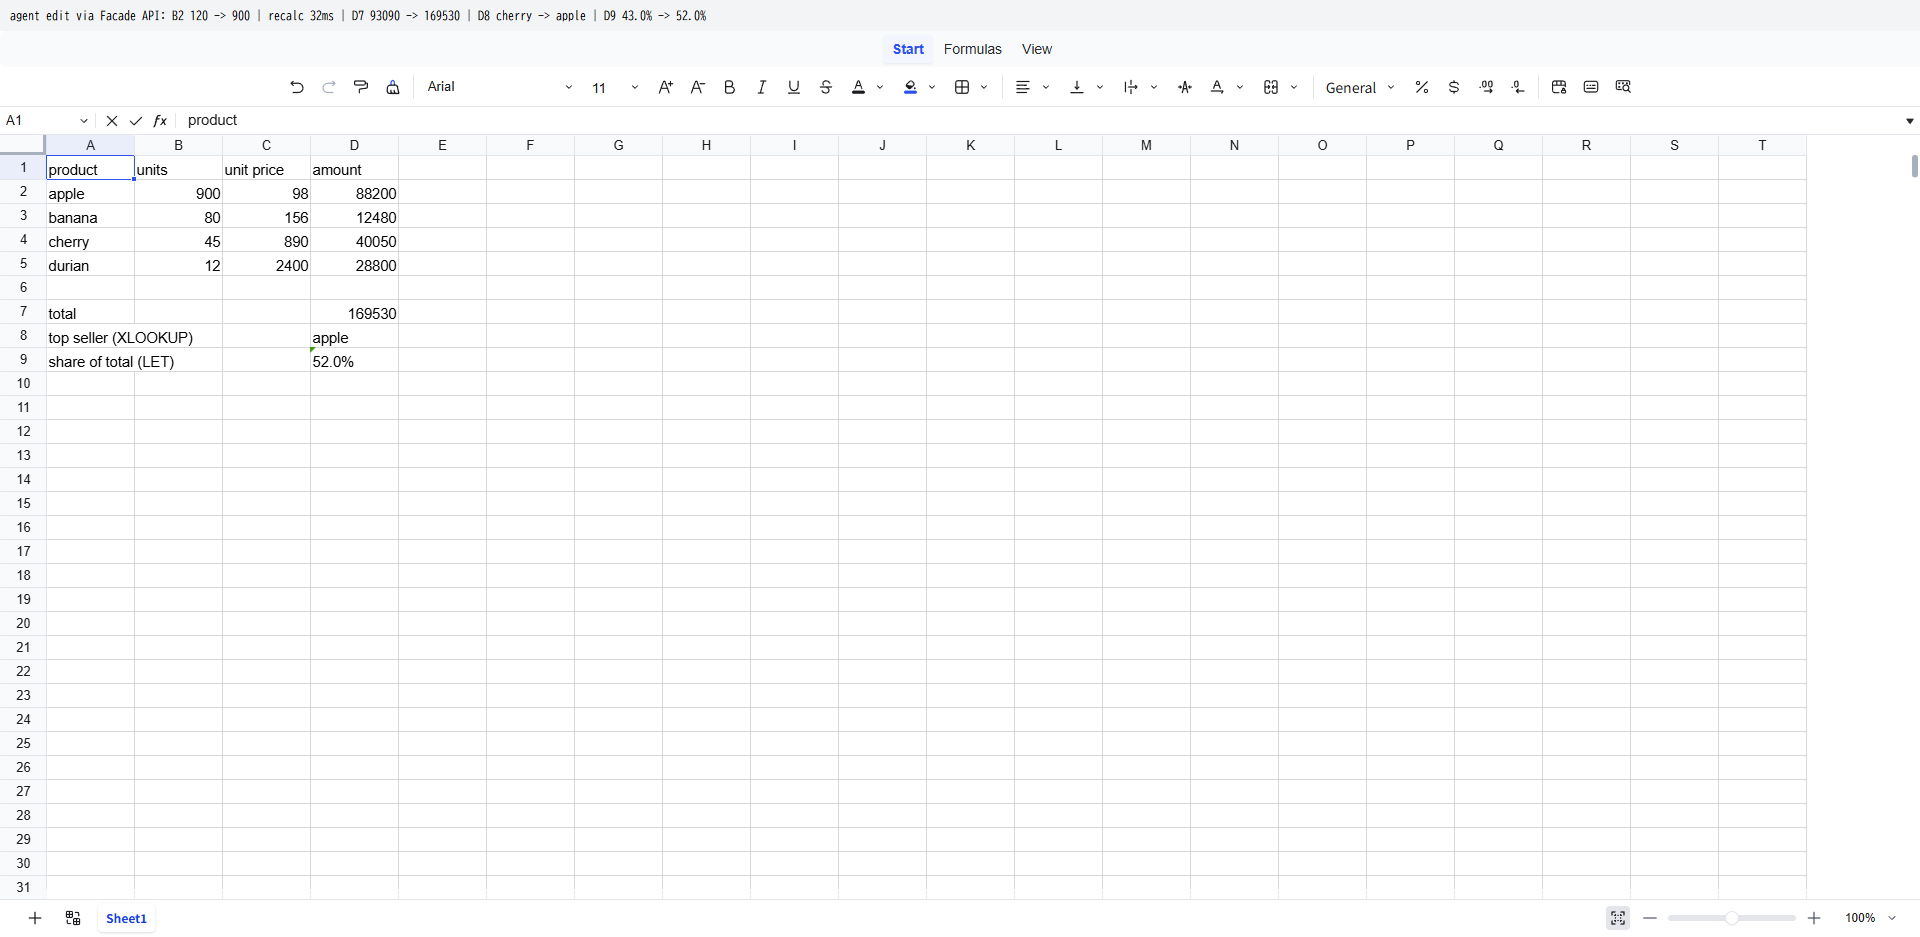
32msで再計算が走り、合計もXLOOKUPの結果も構成比も画面ごと更新されました。「エージェントが直して、人が画面で確かめる」という触れ込みは、この範囲では確かに成立しています。
保存して読み直したときに、数字が嘘をついた
問題はここからです。
OSSの範囲でファイルとして残す手段は、fWorkbook.save() が返すスナップショット(JSON)です。今回の小さなブックで1,367バイト。中身を見ると、式と一緒に計算結果 v がキャッシュとして保存されています。
{"f":"=SUM(A1:A5)","v":150,"t":2}ここで意地の悪いことを試しました。式はそのままに、キャッシュの v だけを150から999に書き換えて読み込ませます。対照として、書き換えていないスナップショットも同じ手順で読み込みます。
# --- 既定のまま読み込む(A1:A5 は 10,20,30,40,50 なので正解は 150)---
node case-load.mjs snap-tampered.json
# on_disk_B1={"f":"=SUM(A1:A5)","v":999,"t":2}
# B1_right_after_load=999
# calculationEnd_state=2 after_ms=17
# no_calculationEnd_within_6000ms fired=true    ← state 3 は最後まで来ない
# B1_after_wait=999                              ← 999 のまま

# --- CalculationMode.FORCED (=0) を渡して読み込む ---
node case-load-forced.mjs snap-tampered.json
# B1_right_after_load=999
# calculationEnd_state=3 after_ms=34
# B1_after_wait=150                              ← 正しい値に直った

# --- 対照: 無改変のスナップショットを FORCED で読む ---
node case-load-forced.mjs snap.json
# B1_after_wait=150(もともと150なので変化なし)
書き換えた999が、式を持ったまま、そのまま返ってきました。
これは不具合ではなく、ソースにそう書いてあります。packages/sheets-formula/src/config/config.ts の CalculationMode は FORCED / WHEN_EMPTY / NO_CALCULATION の3つで、WHEN_EMPTY には「式があって v が無いセルだけ計算する」とコメントが付いています。そして update-formula.controller.ts の初期化処理が config?.initialFormulaComputing ?? CalculationMode.WHEN_EMPTY と書いていて、既定がこれです。開いた瞬間に全再計算しないのは、大きなブックを扱うエディタとしてはむしろ順当な設計だと思います。
厄介なのは、待ち方のほうです。calculationEnd に来た値は 2 でした。engine-formula の FormulaExecutedStateType を見ると 0=INITIAL、1=STOP_EXECUTION、2=NOT_EXECUTED、3=SUCCESS なので、2 は「計算するものが無かった」という意味になります。JSDocのサンプルどおり if (state === 3) で待っているコードは、ここで永遠に解決しないPromiseになります。私のスクリプトも6秒のタイムアウトで抜けていて、それで気づきました。
| 読み込み方 | ディスク上のB1 | calculationEnd | 読み出せた値 |
|---|---|---|---|
| 既定(WHEN_EMPTY) | v=999(改ざん) | state=2 で止まる | 999 |
| FORCED | v=999(改ざん) | state=3 が34msで到達 | 150 |
| FORCED(対照・無改変) | v=150 | state=3 が30msで到達 | 150 |
同じことがブラウザでも起きます。下の画面は、改ざんしたスナップショットをUIに読み込ませたところです。A列に10〜50が並んでいて、B1の式は =SUM(A1:A5) のままなのに、表示は999です。
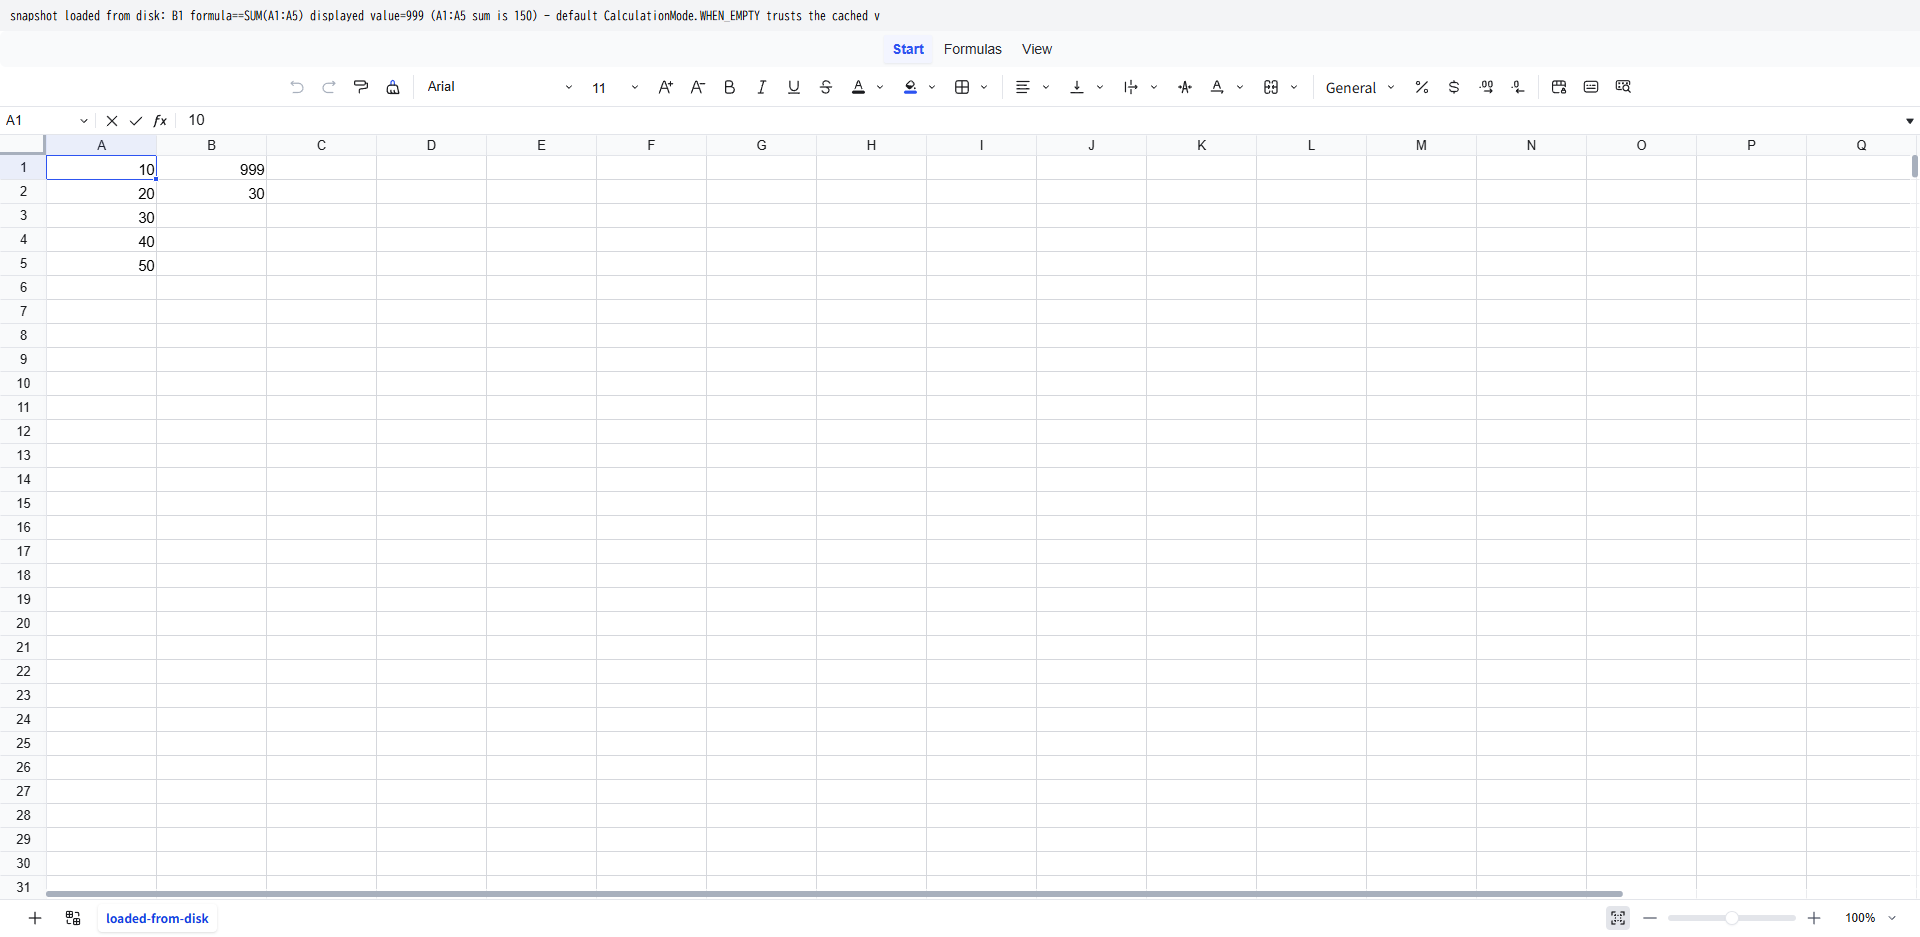
現場の言葉に翻訳すると、こうなります。エージェントが作った(あるいは誰かが手で触った)ファイルの数字は、開いただけでは検算されない。 表計算のファイルを受け取って数字を読む処理を書くなら、UniverSheetsNodeCorePreset({ formula: { initialFormulaComputing: 0 } }) を渡して全再計算させるのが受け入れ条件になります。100,000式で4.8秒(後述)なので、検収のタイミングで一度回すコストとしては十分現実的です。
OSSとProの線引きをどう読むか
もうひとつ、採用判断で必ず聞かれるのがここです。READMEにはOSSとProの対応表が明記されていて、xlsxの入出力・チャート・ピボット・印刷・共同編集はPro側と書かれています。この正直さは好感が持てるところで、実際にOSSリポジトリの packages/ を眺めても、xlsxやexchangeに当たるパッケージは1つもありませんでした。UIのリボンも Start / Formulas / View の3タブだけで、挿入系のタブがそもそも存在しません。
では「Proを買えばxlsxが読める」のかというと、そこも確かめておく必要がありました。@univerjs-pro/exchange-client は公開npmからそのまま入ります(8.1秒・647KB)。中を覗くと、uploadFileServerUrl / importServerUrl / exportServerUrl / getTaskServerUrl といった設定キーと、/universer-api/exchange/task/ /universer-api/stream/file/upload といったパスが埋まっていました。つまりこれは変換サーバーに投げるクライアントで、パッケージ単体では変換できません。ここはコードから読み取れた範囲の事実で、価格や提供形態までは追っていません。
もう1つ、気づいたので事実として書いておきます。OSS側の @univerjs/core は license: Apache-2.0 がnpmのメタデータに入っているのに対し、@univerjs-pro/exchange-client には license フィールドがありません(tarballにもLICENSEファイルが入っていませんでした)。入れようと思えば npm install できてしまう場所にあるので、Pro側を検証で触るなら利用条件を別途確認しておくのが無難だと思います。
テーラリングの観点で整理すると、私の見立てはこうです。
- OSSだけで完結する使い方: 計算モデルをJSONで受け渡す前提の社内システム。式の評価・検証をサーバー側で回し、画面はUnivrのUIで見せる
- Proが要る使い方: 既存のExcelファイルを受け取って返す業務。ここはOSSの守備範囲外なので、線引きを曖昧にしたまま見積もると確実に揉める
どこまでの規模なら回るのか
エディタではなくバッチとして使う話になるので、規模も測りました。A列に数値、B列に =A*2、C列に =SUM(A:B) を入れたシートを、行数を変えて作っています(式の数は行数の2倍)。
node case-perf.mjs 1000     # n=1000  formulas=2000   createWorkbook_ms=36  calc_ms=151   rss_mb=167
node case-perf.mjs 10000    # n=10000 formulas=20000  createWorkbook_ms=49  calc_ms=933   rss_mb=345
node case-perf.mjs 50000    # n=50000 formulas=100000 createWorkbook_ms=114 calc_ms=4863  rss_mb=836

# ブラウザ側の本番ビルド(Vite 8.3.0)
npx vite build
# ✓ built in 1.89s
# dist 合計 11,658,063 bytes
# 主要JS 6,952,320 bytes(gzip 1,764,181)/ CSS 120,193 bytes(gzip 17,457)/ ロケール等のJSチャンク78個
計算時間はおおむね式の数に比例していて、100,000式で4.86秒、常駐メモリ836MBでした。ここは用途次第で評価が割れるところだと思います。バッチで夜間に回すなら十分ですが、APIリクエストの中で毎回50,000行を再計算する設計にすると、メモリのほうが先に苦しくなるはずです。
ブラウザ側は、gzipで1.76MBというのは正直重いほうです。ただ、ロケールが78チャンクに分かれているので、実アプリでは必要な言語だけ読み込む形になります。このあたりは自分たちの構成次第で、今回の数字は「何も考えずに全部入りのプリセットを入れたらこうなる」という上限として見るのが妥当だと思います。
試してみての所感
「フレームワークは目的ではなく道具」といつも言っている手前、最後は道具として使えるかに落とします。
今回の実測から、自分が採用レビューで確認する項目はこうなりました。
- 帳票で使っている関数が通るか(31本のうち通らなかったのはPIVOTBYだけ。ここは対象の帳票で必ず一度回す)
- 読み込み時に全再計算しているか。既定の
WHEN_EMPTYのままだと、ファイルに書かれたキャッシュ値を信じる calculationEndをstate === 3で待つコードが、state === 2(計算不要)で止まったときに固まらないようになっているか- xlsxの入出力が要件に入っていないか。入るならOSSの範囲外で、変換サーバーが前提になる
- 想定行数での計算時間とメモリ(今回は100,000式で4.86秒・836MB)
教科書どおりに言えば「OSSの機能一覧とライセンスを確認しましょう」で終わる話なんですが、実際にやってみて効いたのは、わざと壊した入力を1件用意して、正しい入力と並べて読ませたことでした。999という嘘の数字を混ぜていなければ、私は「ちゃんと150が出ますね」で終わらせていたと思います。
Univer自体は、Nodeで素直に動いて式もよく通る、良くできた基盤だという印象です。エージェントに表計算を任せる構成を組むなら、次は自分の手元の帳票テンプレートを流し込んで、関数の穴を洗うところからやってみるつもりです。