GitHubのトレンドを眺めていたら、1位に JetBrains/thinkrail がいました。説明は「Vibe code with pi in a lightweight, real IDE that customises itself around the way you work」。確認した時点でスターは 4,548、その日だけで 1,075 増えていました。
私は普段、開発チームにツールを入れるかどうかを決める側にいます。現場では、新しいAIツールの評価で最初に聞かれるのは「何ができるか」より「何がどこへ送られるか」なんですよね。README には「pi を同じプロセスで動かす薄いホストで、裏でプロンプトを組み立てることはない」とあり、利用状況の送信(アナリティクス)についても節が1つ設けられています。そこで、書いてあることを実物の通信で確かめることにしました。
試した環境
- Windows 11 + Docker Desktop(Engine 27.3.1)の上の使い捨てコンテナ(
node:22-bookworm、Debian 12、glibc 2.36、Node v22.23.1) - ThinkRail 0.2.0(タグ v0.2.0 =
7641d7df9f)。README の公式インストーラーで CLI 版を入れました - 比較用に、ThinkRail v0.2.0 が依存している版と同じ pi 1.2.0(
@earendil-works/pi-coding-agent)を npm で入れました - 画面の操作と撮影は、コンテナの中の Playwright 1.56.1(Chromium headless shell 141.0.7390.37)
デスクトップ版は README に「glibc 2.38+、Ubuntu 24.04 以降」とあり、Debian 12 では条件を満たしません。なので最初から CLI 版にしました。CLI 版は同じアプリをブラウザで開く形です。
LLM は本物を使っていません。コンテナの中に OpenAI 互換のモックを自作し、届いた要求の本文をそのまま保存するようにしました。インストールが済んだ時点でコンテナをネットワークから切り離し、/etc/hosts で PostHog(利用状況の送り先)のホスト名をコンテナ内の小さなロガーへ向けています。つまり、この検証から外へは何も出ていません。
入れるまでは拍子抜けするほど軽い
インストーラーは、GitHub Releases からバイナリと SHA256SUMS を取ってきて照合し、~/.local/bin に置いて ~/.bashrc に PATH を1行足すスクリプトでした。中身は流す前に読んでいます。
$ curl -fsSL https://raw.githubusercontent.com/JetBrains/thinkrail/main/install.sh | bash
Downloading thinkrail-linux-x64 ...
# (進捗バーの行は省略)
Downloading SHA256SUMS ...
Verifying checksum ...
  → ok
Installed → /root/.local/bin/thinkrail

ThinkRail 0.2.0 (stable) installed.
# ↑ここまで 6,611ms。バイナリは 139,994,312 バイト

$ thinkrail --version
0.2.0

$ thinkrail --help   # Options の一部だけ抜粋
  --port <n>     Listen port (default 24242; falls back to a free port if taken).
  --host <h>     Bind host (default localhost).
  --no-open      Don't open the browser (e.g. headless / remote host).
  --no-analytics Disable additional usage analytics this run.
thinkrail --no-open --host 127.0.0.1 --port 8080 /work/proj-tr で起動すると、約0.85秒で listening on port 8080 が出ました。
モデルの設定は ThinkRail 側ではなく、pi の ~/.pi/agent/models.json に書きます。pi の docs/models.md にある「OpenAI 互換のエンドポイントを足す」例をそのまま自分のモックへ向けました。
{
  "providers": {
    "mock": {
      "baseUrl": "http://127.0.0.1:4000/v1",
      "api": "openai-completions",
      "apiKey": "mock",
      "models": [ { "id": "mock-1" } ]
    }
  }
}
この1ファイルだけで、ThinkRail のチャット欄のモデル選択に mock-1 が最初から出てきました。ログインの画面は一度も通っていません。
最初に出てきたのは「利用データの共有」の確認
ブラウザで開くと、プロジェクトを選ぶ画面の上に「Help improve ThinkRail」というダイアログが重なって出ます。
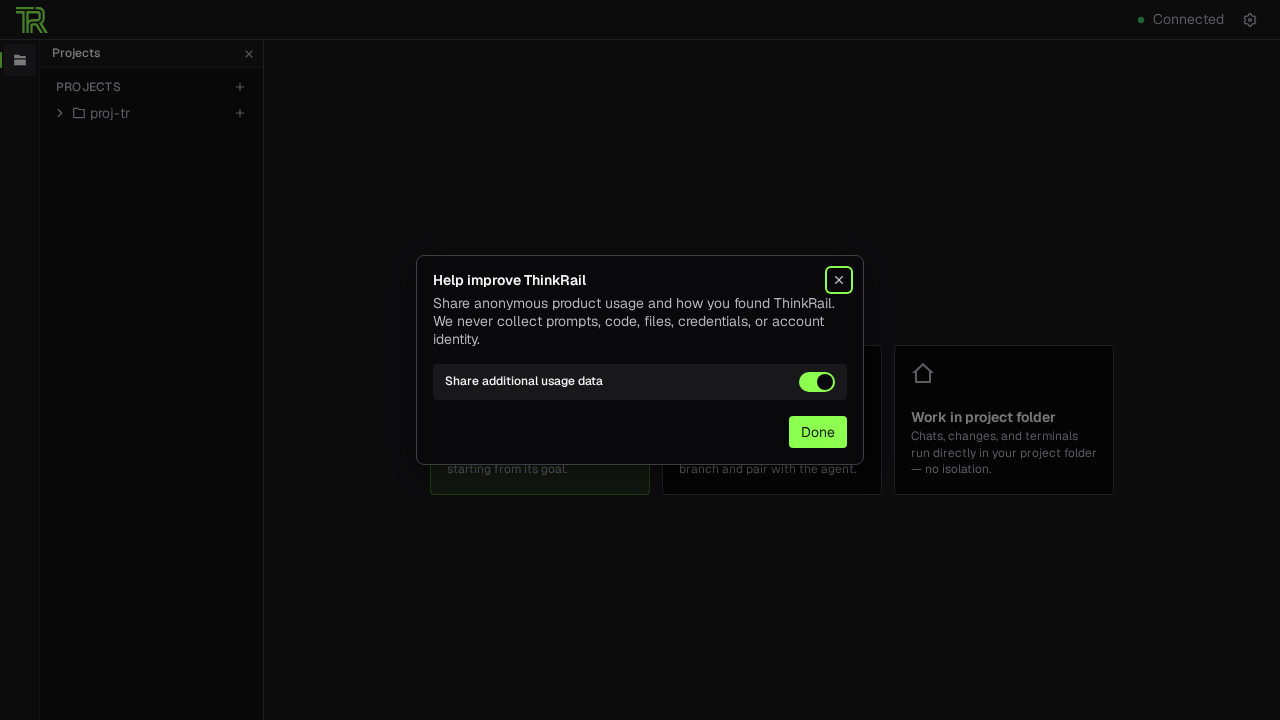
文面は「匿名の利用状況と、ThinkRail をどこで知ったかを共有してください。プロンプト・コード・ファイル・認証情報・アカウントの身元は集めません」。スイッチは最初からオン(緑)でした。既定のまま「Done」を押したあとの ~/.thinkrail/config.json には "analyticsEnabled": true と "analyticsConsentConfirmed": true が書かれていました。
理屈はそうなんですが、と言いたくなるのはここです。README には「追加の利用データはスイッチがオンの間だけ共有する」と書いてあり、その通りの動きではあります。ただ、チームに配るなら「初回のダイアログで何もせず Done を押すと同意したことになる」は、導入手順書に1行書いておくべき事実だと思いました。
「こんにちは」1通で、モデルに何が届いたか
ここからが本題です。pi 単体と ThinkRail に、同じモックへ同じ「こんにちは」を送らせて、モックが受け取った要求を比べました。
モック側のログと、2つの要求を突き合わせたスクリプトの出力です。
# pi 1.2.0 単体: pi -p "こんにちは" --provider mock --model mock-1 --no-session(rc=0・249ms)
2026-10-28T12:06:52.891Z POST #1 bytes=5816 stream=true model=mock-1 msgs=2 sysBytes=2700 tools=4 toolsBytes=2841 names=read,bash,edit,write
# ThinkRail 0.2.0: 新しいチャットで「こんにちは」を送信(names= は途中から省略)
2026-10-28T12:08:31.864Z POST #2 bytes=50438 stream=true model=mock-1 msgs=2 sysBytes=14293 tools=28 toolsBytes=35745 names=read,bash,edit,write,web_search,fetch_content,...
# 同じチャットで2通目「ありがとう」(names= は省略)
2026-10-28T12:09:30.476Z POST #3 bytes=50586 stream=true model=mock-1 msgs=4 sysBytes=14293 tools=28 toolsBytes=35745
# ※モックは usage を固定値で返すので、量はこのバイト数で見るしかない。測り方は改善の余地あり

# 2つの要求の突き合わせ(抜粋。keys B は A と同じ並びなので省略)
user A: ["[{\"type\":\"text\",\"text\":\"こんにちは\"}]"] | user B: ["[{\"type\":\"text\",\"text\":\"こんにちは\"}]"]
keys A: model,messages,stream,stream_options,store,max_completion_tokens,tools
builtin read identical: true 684 684
builtin bash identical: true 543 543
builtin edit identical: true 1179 1179
builtin write identical: true 430 430| 項目 | pi 1.2.0 単体 | ThinkRail 0.2.0 |
|---|---|---|
| 要求の回数 | 1回 | 1回 |
| 要求の大きさ | 5,816 バイト | 50,438 バイト(約8.7倍) |
| system プロンプト | 2,700 バイト | 14,293 バイト |
| ツールの定義 | 4個・2,841 バイト | 28個・35,745 バイト |
| 利用者の文面 | 「こんにちは」だけ | 「こんにちは」だけ(同一) |
| read / bash / edit / write の定義 | ― | pi 単体と1バイトも違わない |
まず、README の「裏でプロンプトを組み立てない」は、利用者の文面については本当でした。「こんにちは」は一字も足されずに届いていますし、pi 本来の4つのツールも1バイトも変わっていません。要求の項目の並びも同じです。
増えていたのは、ThinkRail に同梱されている pi の拡張が載せる分です。system プロンプトには、pi 単体に無い <skills>(12個の skill の名前と説明で 5,224 バイト)、<pi-spec-graph>・<pi-thinkrail-workflow>・<pi-todos> の節が足され、ツールの一覧と作法を書いた節もそれぞれ 339→2,926 バイト、839→2,939 バイトに伸びていました。ツールのほうの内訳はこうです。
| 足されたツール | 数 | 定義の大きさ |
|---|---|---|
| todo_list / todo_add / todo_update など todo 系 | 7 | 10,596 バイト |
| spec_create / spec_grep / spec_graph など spec 系 | 7 | 6,096 バイト |
| web_search / fetch_content / get_search_content | 3 | 5,357 バイト |
| ask_user_question | 1 | 3,736 バイト(単独では最大) |
| Agent / get_subagent_result | 2 | 2,752 バイト |
| visualize / background_command / set_title / resolve_comment | 4 | 4,343 バイト |
| 合計 | 24 | 32,880 バイト |
ひとつ面白かったのが、system プロンプトの末尾に付いていた <pending-naming> という節です。
<pending-naming>
Naming is still pending: this chat has no title yet. If this request has a concrete task, call set_title with chat_title before your other tool calls (right after reading a linked PR, issue, or ticket, if any). Otherwise ignore this note.
</pending-naming>
チャットの題名は、別の要求を立てて付けるのではなく、本体の要求の中でモデルに set_title を呼ばせる設計のようです。私のモックは set_title を呼ばないので、2通目の要求にもこの節が残ったままでした(2通目は 50,586 バイト)。題名を付けてくれないモデルを使うと、この 273 バイトが毎回付いてくることになります。
それと、画面上部の「↑10・↓5」はモックが返した usage(prompt_tokens=10、completion_tokens=5)と同じ数字でした。実際には約50KBを送っているのに、メーターは 0.0%/128k のままです。このモックは usage を固定値で返す作りなので、本物のプロバイダなら本物の数字が出るはずです(未確認)。
外への通信: 3秒おきに4回ずつ
listening on port 8080 のログから約5ミリ秒後には、eu.i.posthog.com の443番へつなぎに来ていました。コンテナはオフラインなので、送信は毎回失敗します。
# /etc/hosts で PostHog のホスト名をコンテナ内のロガーへ向けた状態(中身は TLS なので見ていない)
2026-10-28T12:07:03.730Z port=443 host=eu.i.posthog.com first=TLS ClientHello bytes=517
2026-10-28T12:07:06.739Z port=443 host=eu.i.posthog.com first=TLS ClientHello bytes=517
2026-10-28T12:07:09.741Z port=443 host=eu.i.posthog.com first=TLS ClientHello bytes=517
2026-10-28T12:07:12.742Z port=443 host=eu.i.posthog.com first=TLS ClientHello bytes=517

# 同じ時刻の ~/.thinkrail/logs(--verbose で起動。debug レベルでしか出ない)
{"level":20,"levelName":"debug","time":"2026-10-28T12:07:12.744Z","schemaVersion":1,"scope":"analytics","msg":"analytics send failed"}
基本は、3秒おきに4回つなぎに来て、4回目の直後に analytics send failed が1行残る、という形でした(送信が重なったときは2本が並行していました)。画面の右上は「Connected」のままで、失敗が利用者に見えることはありません。
--no-analytics を付けて起動し直したときの回数も数えました。
| 起動のしかた | 起動直後 | 新しいチャットを開いて1通送ったあと |
|---|---|---|
| 既定(ダイアログは既定のまま Done) | 4回 | 16回(開いたとき4回+送ったとき12回) |
| —no-analytics | 4回 | 8回 |
--no-analytics でも0にはなりません。README には、起動・チャット作成・送信などの基本の利用イベントを集めること、エラー報告は常に送ること、--no-analytics が止めるのはその回の「追加の」共有だけであることが書かれていて、それと矛盾しない動きです。回数が半分になったのが --no-analytics の効き目なのかは、中身が TLS で見えないので言い切れません。既定のほうは「開く」と「送る」を別々のページ読み込みでやっていて、条件も完全には揃っていません。ちなみに --no-analytics で送った「こんにちは」の要求は、既定のときと同じ 50,438 バイトでした。
正直に書いておく失敗
実は最初、この表を作るときに比べ方を間違えていました。既定の回では画面を操作しながらの最初の75秒(12回)、--no-analytics の回では何も操作しない75秒(4回)を数えて、「3分の1になった」と書きかけていたんです。今思えば、条件を揃えて比べるという基本を外していました。同じ操作をやり直したのが上の表です。
もう1つ、Playwright で入力欄を textarea[placeholder="Message…"] と指定したら、自分のスクリプトの引数の区切りに = を使っていたせいでセレクターが壊れ、1回目の送信は空振りしました。textarea:not([aria-label]) に変えて通っています。ThinkRail のせいではありません。
試してみての所感
フレームワークは目的ではなく道具、と私はよく言いますが、ThinkRail はまさに「pi という道具に、仕様(spec)と todo とサブエージェントの作法を足した道具」でした。足しているものは隠されておらず、system プロンプトとツールの定義を見れば全部読めます。そこは好感が持てました。
ただ、チームに入れるなら、私は次の3つを導入手順書に書きます。
- 初回のダイアログは、既定のまま Done を押すと追加の利用データ共有に同意したことになる(
analyticsEnabled: true) --no-analyticsを付けても PostHog(eu.i.posthog.com)への接続は起きる(README によれば基本の利用イベントとエラー報告)。止めたい環境では通信の側で塞ぐ- 「こんにちは」1通でも約50KB、そのうちツールの定義が約36KBを占める。従量課金のモデルにつなぐなら、拡張を足すたびにこの土台が増えることを見込む
テーラリングの観点では、todo 系だけで約10.6KBあるので、使わない拡張を外したときにどれだけ軽くなるかが次に知りたいところです。設定で外せるのか、外したら system プロンプトのどの節が消えるのかは、今回は見ていません。本物のモデルにつないだときに set_title がちゃんと呼ばれて <pending-naming> が消えるのかも、様子見のままです。
ここは好みが分かれるところですが、「何を足したかを全部見せてくれる重いツール」と「何も足さない軽いツール」なら、私は前者のほうが現場では扱いやすいと思っています。中身が読めれば、削る判断ができるので。